KI On-Premises: Souverän, aber teuer
Offene KI-Modelle haben zu den kommerziellen Anbietern aufgeschlossen. Das weckt bei vielen Unternehmen den Wunsch, KI im eigenen Haus zu betreiben, mit eigenen Daten und unabhängig von amerikanischen oder chinesischen Anbietern. Doch was verlangt On-Prem-Hosting an Hardware, Know-how und Budget?
KI gehört im Arbeitsalltag inzwischen zum Standard. Der Effizienzgewinn ist gross, ebenso gross sind aber auch die KI-Kosten pro Mitarbeitenden. Ihren vollen Nutzen entfaltet KI allerdings erst, wenn sie mit den Firmendaten arbeiten kann. Genau hier tun sich viele Unternehmen schwer, denn die etablierten Anbieter sind heute ausschliesslich amerikanische oder chinesische Firmen.
Damit stellt sich die Frage, ob mittlere und grosse Unternehmen ihre KI-Infrastruktur nicht selbst betreiben können. Eine IT-Abteilung und Server-Infrastruktur sind schliesslich vorhanden. Dieser Beitrag zeigt, was der Betrieb von KI On-Premises bedeutet. Für einen Business-Entscheid sollte zusätzlich die Option Cloud-Hosting geprüft werden.
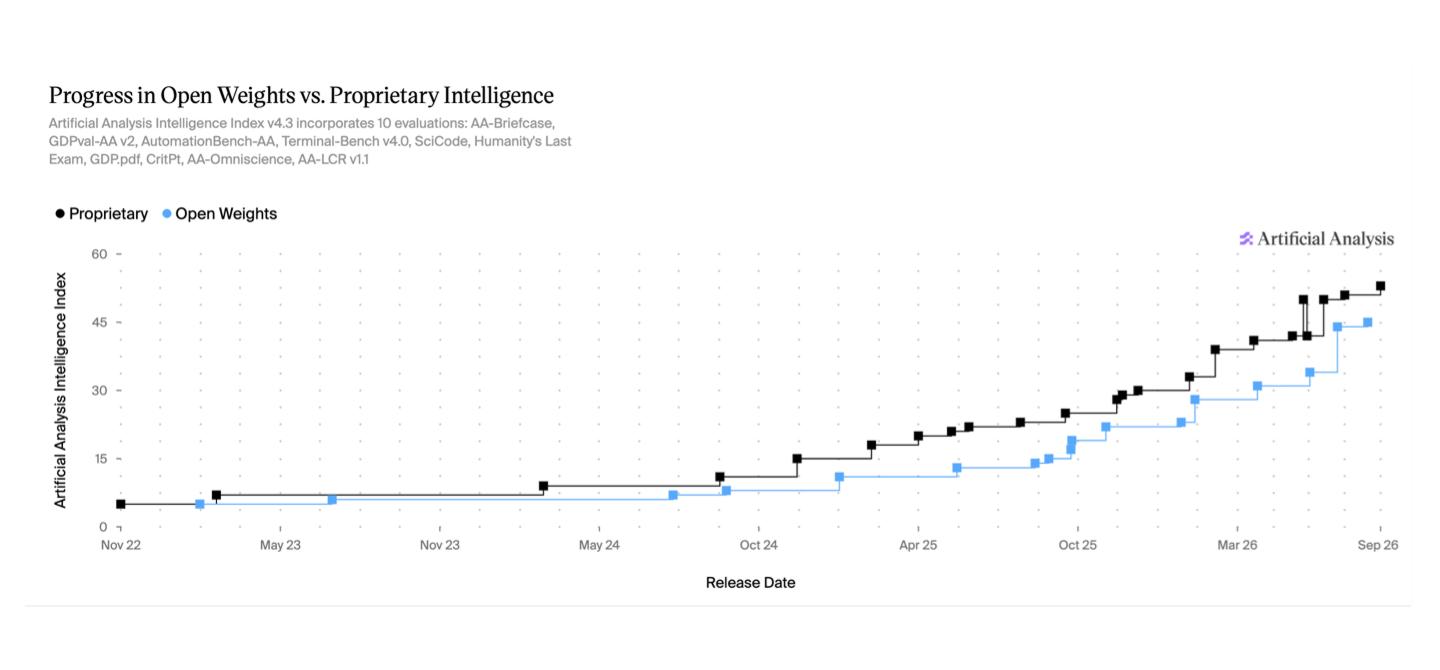
Intelligenz und Grösse dieser Modelle variieren stark. Bei Sprachmodellen hängt die Intelligenz von Grösse, Architektur und Trainingsdaten ab. Jede neue Modell-Generation war bisher deutlich grösser als ihre Vorgängerin. Das funktionierte gut, hat aber seinen Preis: höhere Hardware-Anforderungen. In einem zweiten Schritt wird ein solches Modell optimiert, damit es bei gleicher Intelligenz weniger Ressourcen benötigt. Die folgende Grafik zeigt das in der Praxis.
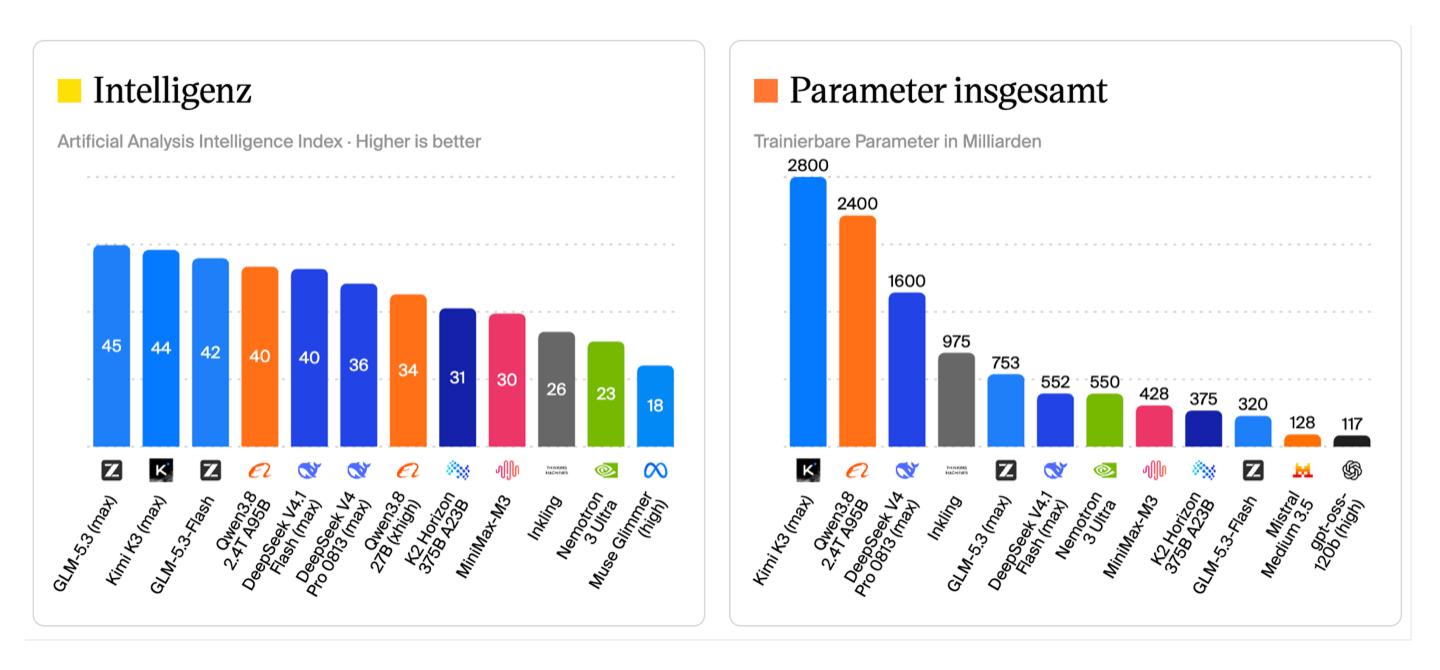
Bei den führenden offenen Modellen sind die Unterschiede in der Intelligenz gering, jene in der Grösse dagegen erheblich. So schnitt etwa GLM-5.3-Flash mit 320 Milliarden Parametern in Tests besser ab als DeepSeek V4 Pro mit 1'600 Milliarden Parametern.
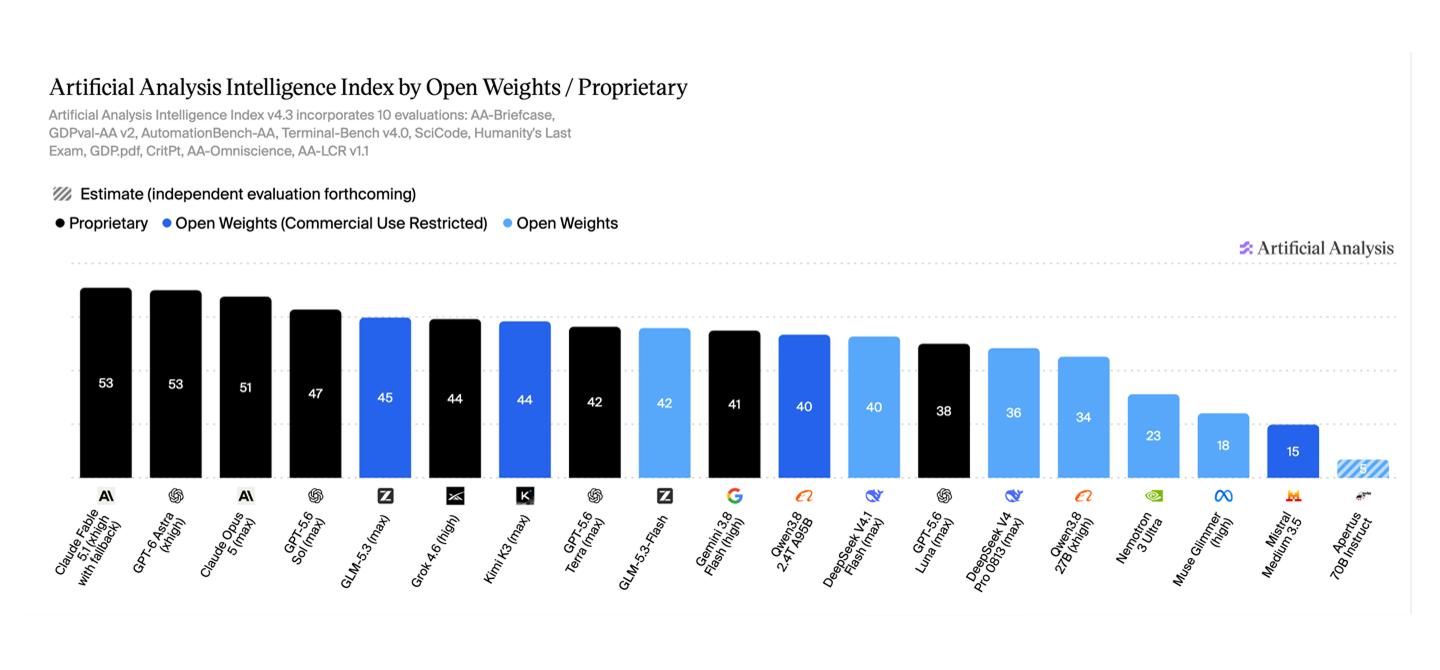
Die führenden offenen Sprachmodelle stammen von chinesischen oder amerikanischen Laboren; europäische Modelle sind weit abgeschlagen. Das Schweizer Modell Apertus (V1) erreicht auf dem AA-Intelligenz-Index nur gerade 5 Punkte, die chinesischen Modelle dagegen 40 (DeepSeek V4.1 Flash) bis 45 Punkte (GLM-5.3).
Speicherbedarf und Quantisierung
Kimi K3 ist eines der leistungsfähigen offenen Modelle und liegt nur knapp hinter Fable 5 und GPT-5.6 Sol. Mit 2,8 Billionen Parametern ist es allerdings auch sehr gross und benötigt allein für die Modell-Gewichte 1,5 TB RAM.
Der Speicherbedarf eines Modells hängt von der Anzahl der Parameter und der Präzision ab: Ein 30B-Modell mit 8-Bit-Präzision benötigt 30 GB RAM. Um Ressourcen zu sparen, lässt sich die Präzision reduzieren, etwa auf 4-Bit oder 2-Bit. Dieser als Quantisierung bezeichnete Vorgang senkt den Speicherbedarf erheblich, kostet aber Qualität. Bei hohem Nutzeraufkommen ist er dennoch gängige Praxis, um alle Anfragen bedienen zu können. NVIDIA bietet mit NVFP4 eine 4-Bit-Quantisierung für seine GPUs an, die bei sehr grossen Modellen praktisch keinen Qualitätsverlust gegenüber 8-Bit hat – das macht sie fürs Hosting attraktiv. Bei kleineren, dichten Modellen (unter 30B) kommt es dagegen zu Einbussen: Hier empfiehlt sich Dynamic NVFP4, das nur die weniger empfindlichen Teile des Modells in 4-Bit speichert.
Für die meisten Aufgaben genügen kleine bis mittlere Modelle; für komplexere führt an grossen Modellen kein Weg vorbei. Als Orientierung: Ein kleines Modell hat rund 30 Milliarden Parameter, ein mittleres etwa 300 Milliarden, ein grosses 1'000 bis 3'000 Milliarden.
Wie viel Ressourcen die Nutzung braucht
Das Nutzungsverhalten macht einen grossen Unterschied. Chat braucht wenig Ressourcen; wir rechnen mit 32k Token Kontext. Entwickler-Agenten brauchen massiv mehr, weil auch Code und Dokumentation zur Anfrage gehören. Hier rechnen wir mit 300–500k Token Kontext. Ein Wort entspricht etwa 2 Token.
Bei jeder neuen Anfrage muss die gesamte Repräsentation der Konversation (KV-Cache) in den GPU-Speicher geladen werden. Bei langen Konversationen sind das mehrere Dutzend bis Hunderte Gigabyte – und sie können den Speicherverbrauch des Modells selbst übersteigen. Deshalb ist eine hohe Speicherbandbreite so wichtig.
Geeignete Hardware braucht also sehr viel schnellen (und teuren) Speicher.
Die passende Hardware
Enterprise-Lösungen basieren heute auf NVIDIA-GPUs der Blackwell-Serie oder auf AMD-GPUs. State of the Art ist derzeit die B300 GPU von NVIDIA, etwa in der DGX B300 (10U-Server mit 8 GPUs) oder, noch effizienter, als GB300 NVL72 im flüssigkeitsgekühlten Rack mit 72 GPUs und 36 CPUs.
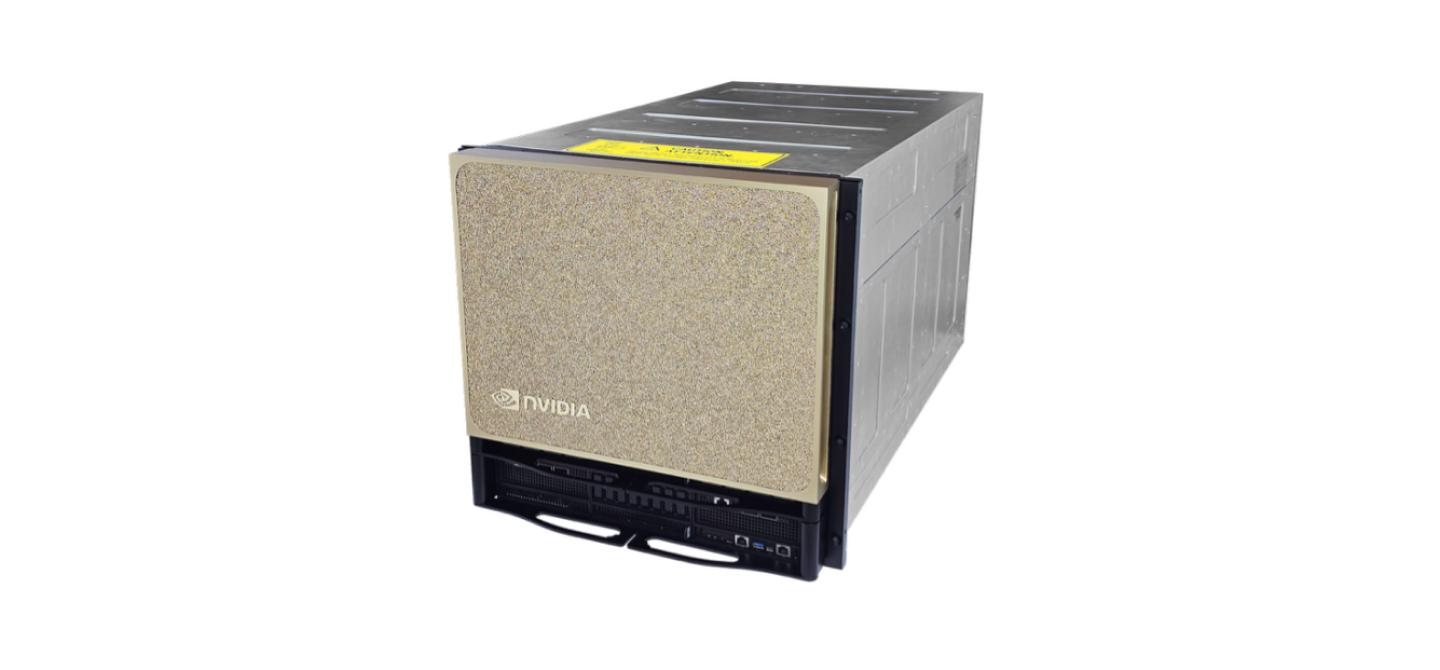 Abbildung 4: NVIDIA DGX B300 AI Server mit 8 GPUs
Die älteren GPUs der Hopper-Serie wie H100 oder H200 sind noch weit verbreitet. Sie unterstützen jedoch kein NVFP4 und sind um den Faktor 2–4 (8 GPUs) bis 50 (72 GPUs) weniger energieeffizient. Noch effizientere GPUs der Vera-Rubin-Serie sind noch ausschliesslich für die grossen Anbieter reserviert.
Die Effizienz ihrer Systeme gibt NVIDIA in den Marketingunterlagen in Token pro Megawatt an, Zielgruppe sind primär grosse Rechenzentren.
Rechenbeispiele
Die folgenden Beispiele zeigen, wie sich ein DGX-B300-Server im Unternehmen einsetzen liesse. Es handelt sich um berechnete Prognosen, nicht um Messwerte.
Szenario 1 – Business-Alltag
Chat mit 32k Token Kontext, Geschwindigkeit vergleichbar mit Copilot. Aufteilung:
- 2 GPUs: Qwen3.8-27B für leichtere Aufgaben (vergleichbar mit Claude Sonnet)
- 6 GPUs: GLM-5.3-Flash für komplexere Aufgaben (vergleichbar mit Claude Opus)
Das reicht für 50–100 gleichzeitige Anfragen bzw. 500–1'200 tägliche Nutzer.
Szenario 2 – Entwickler-Team
Entwickler-Sessions haben im Schnitt 300k Token Kontext, der Output sollte 50–60 Token/Sekunde betragen: Modell ist GLM-5.3-Flash. Pro Modell-Instanz sorgen 2 GPUs für bessere Performance, womit sich 4 Instanzen ergeben. Das reicht für 8–16 gleichzeitig laufende Coding-Agents bzw. 10–25 Entwickler.
Ältere Hardware
Auf den noch weit verbreiteten H100-GPUs sieht es anders aus: Für Qwen3.8-27B (80–120 Token/Sekunde) ist eine GPU bereits mit 1–2 Sessions ausgelastet, mit technischen Tricks wie Multi-Token-Prediction sind 2–4 Sessions möglich. Eine einzige GLM-5.3-Flash-Session benötigt 2 H100-GPUs, um 50–70 Token/Sekunde zu erreichen.
Sicherheit
Self-Hosting schützt die Unternehmensdaten vor unberechtigtem Zugriff durch den Modellanbieter. Risiken bleiben jedoch:
- Das Verhalten eines Modells ist politisch geformt. Die meisten Modelle – amerikanische wie chinesische – haben einen Bias.
- Mehrere chinesische Coding-Modelle erzeugten mehr und stärker verschleierte Schwachstellen, wenn der Prompt nach einem US-Behördenkontext klingt. Besonders auffällig war Qwen. (Quelle: Booz Allen, 2026)
- Modelle können anfällig für Prompt Injections sein: Sie führen dann Aufgaben aus, die nicht vom Nutzer stammen, sondern über eine externe Quelle eingeschleust wurden. Ohne zusätzliche Anwendungsschicht sind die Nutzer ungeschützt.
Durch die Open-Weights-Lizenz ist der Modellanbieter von jeglicher Haftung befreit – die Risiken der Nutzung trägt der Anwender.
Umsysteme
Das Modell ist nur das «Gehirn». Es braucht zusätzlich eine Plattform, die es ausliefert und mindestens Zugriffsverwaltung, Abrechnung, Sicherheitsprüfung und Lastverteilung übernimmt. Kommerzielle Open-Source-Tools wie Bifrost oder LiteLLM leisten das.
Der Tech-Stack einer KI-Plattform lässt sich beliebig erweitern. Funktionen wie Vektor-Suche, Evaluationen, MCP-Registry und Coding-Sandboxen gehören bei den Hyperscalern zum Standardangebot – On-Premises müssen sie selbst bereitgestellt und unterhalten werden.
Kosten
Der Betrieb grosser Sprachmodelle stellt deutlich höhere Anforderungen an Hardware, Strom und Kühlung als klassische Anwendungen. Ein 14-kW-Server mit 5,6 kW Kühlung (PUE 1,4) verbraucht im Schnitt 172 MWh pro Jahr; ein Rack-Server mit 72 GPUs bereits rund 1,5 GWh pro Jahr. Bei durchschnittlichen Stromkosten von 20Rp/kWh sind das 34'400.- bzw. 300'000.- Energiekosten pro Server und Jahr.
Der weltweite Ausbau von KI-Rechenzentren hat den Markt für GPUs und Speicher praktisch ausgetrocknet: Der RAM-Preis hat sich in den letzten 18 Monaten verzehnfacht, die Preise für GPUs verdreifacht. Es gibt nur zwei GPU-Anbieter und die Lieferfristen für KI-Server betragen mehrere Monate.
Ein NVIDIA DGX B300 mit 8 GPUs kostet je nach Anbieter zwischen 400'000 und 700'000 Franken, das Vorgängermodell DGX B200 zwischen 300'000 und 400'000 Franken. Beide benötigen 14 kW; die anfallende Wärme muss abgeführt werden, was nochmals 3–6 kW für die Kühlung bedeutet. Die Kosten für die Kühlungsinfrastruktur liegen erfahrungsgemäss bei 30–50 % der Hardwarekosten. Hinzu kommen die standortabhängigen Stromkosten, die bei der Budgetierung nicht vernachlässigt werden dürfen.
KI-Modelle entwickeln sich schnell: Mehrmals pro Jahr erscheinen neue, bessere oder effizientere Versionen, die zügig ausgerollt werden sollten. Auch das nötige Tooling will betreut sein. Für den Betrieb der eigenen KI-Infrastruktur sind daher 2–3 Personen ein realistisches Minimum.
Fazit
Wer heute neue KI-Hardware kauft, zahlt wegen der hohen Nachfrage und der beschränkten Produktionskapazität einen stolzen Preis. Wer die Investition nicht scheut, kann sich damit eine Infrastruktur aufbauen, die qualitativ mit den Angeboten der grossen Anbieter mithält. Die KI-Infrastruktur muss allerdings konstant betreut und aktualisiert werden.
Internes Hosting schützt Unternehmensdaten vor amerikanischer oder chinesischer Jurisdiktion. Es schützt aber nicht vor dem, was in den Gewichten steckt.
Unsere Expertinnen und Experten unterstützen Sie bei Planung und Aufbau einer internen KI-Infrastruktur.