Large Language Models als Game-Changer
Künstliche Intelligenz // Spätestens als mit Geoffrey Hinton Anfang Mai ein weiteres Urgestein der KI-Forschung vor dem Potenzial der «neuen» KI gemahnt hat, war klar: Die aktuelle Entwicklung ist wohl nicht einfach mit einem kurzfristigen Hype-Cycle zu erklären.
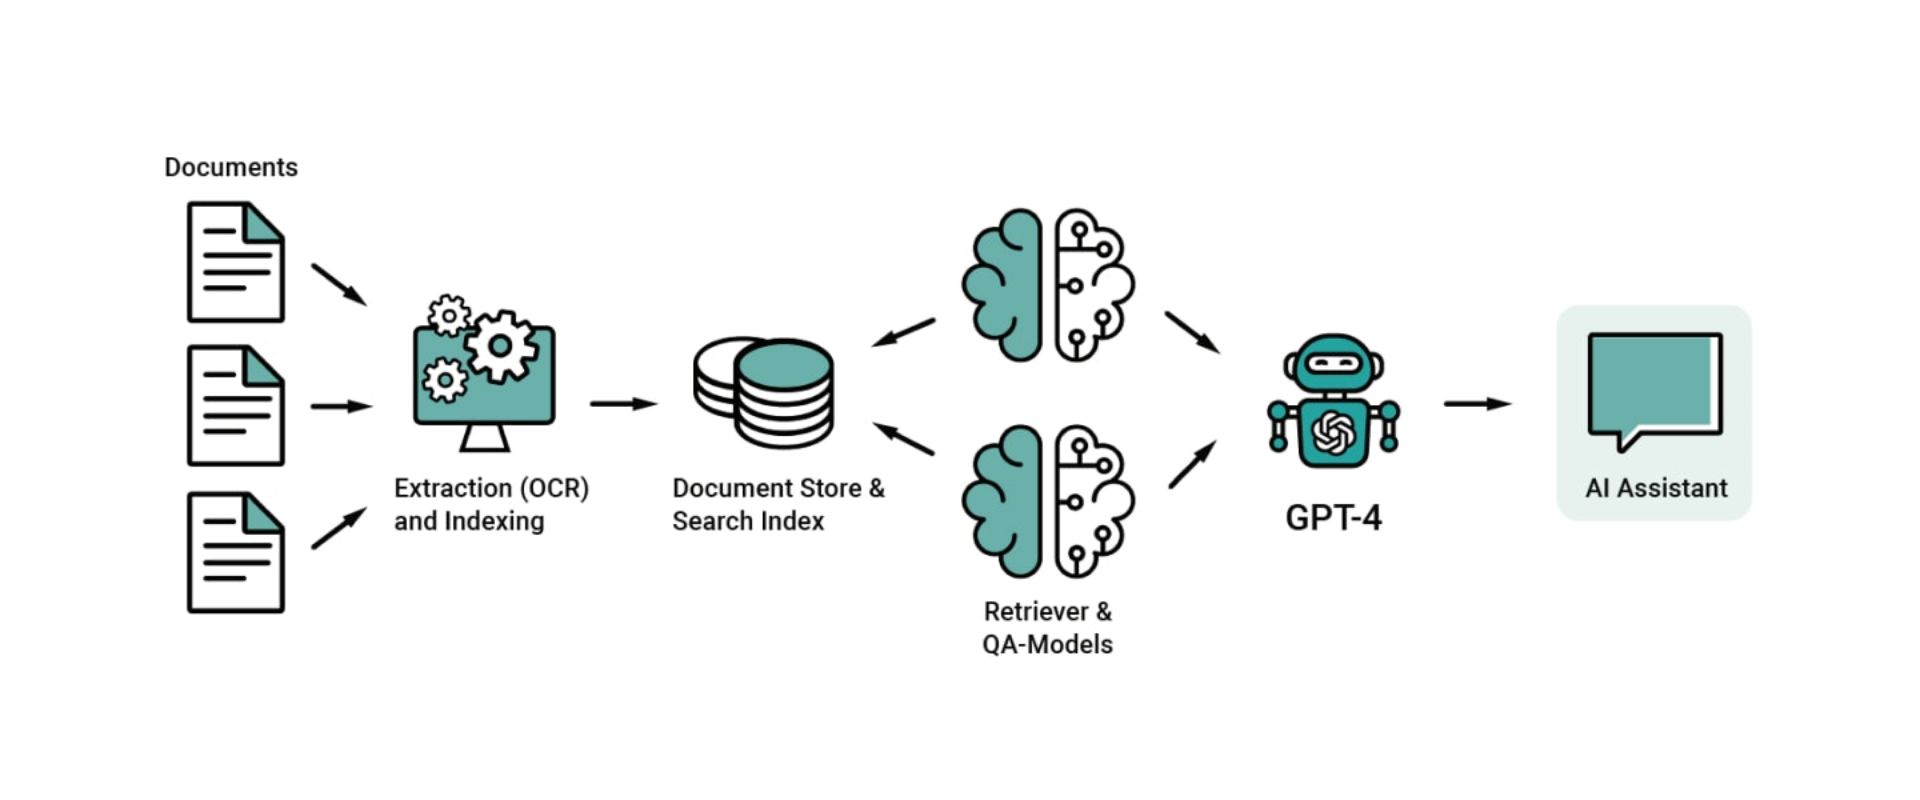
Was ist passiert? Bereits vor einigen Jahren zeichnete sich ab, dass der Grund für Verbesserungen der KI nicht unbedingt in brillanten menschlichen Tricks, sondern viel eher in der massiven Skalierung von Daten, mehr Rechenpower und grösseren Modellen zu suchen ist. Richard S. Sutton hielt diese Erkenntnis 2019 in seinem vielbeachteten Essay «The Bitter Lesson» fest, und in den Jahren 2022 und 2023 hat sich diese Erkenntnis bewahrheitet: OpenAI erschuf mit GPT-3.5/4 mithilfe massiver Rechenpower, grosser Datenmengen und makellosem Engineering ein Modell, das Menschen überall auf der Welt begeistert. In Form von ChatGPT für alle zugänglich, erleichtert dieses generalistische Modell die Arbeit für viele unterschiedliche Berufe.
Und das ist erst der Anfang. Bereits jetzt ist klar, dass die nächste Generation dieser Modelle nicht nur Text, sondern auch Bilder, Kamera-Feeds, Audiodateien oder gar Sensorik von Robotern verarbeitet. Gleichzeitig ziehen die grossen Player im Bereich KI mit ähnlichen Modellen nach – Google stellte sein Modell PaLM 2 Ende Mai mittels API zur Verfügung, und bereits jetzt gibt es Open-Source-Modelle, die der Performance von GPT-4 und Co. nahekommen. Nicht nur für Endbenutzerinnen und -benutzer ist die Entwicklung von solchen Large Language Models (LLMs) wie GPT-4 interessant. Auch für die Machine Learning Engineers von ti&m verändert sich die Arbeitswelt damit. Waren Projekte im Bereich Machine Learning und KI bisher oft anspruchsvoll und teilweise mit hohen Aufwänden verbunden, ermöglichen LLMs ein völlig neues Vorgehen. Ein konkretes Beispiel: Wollte ein Kunde aus der Versicherungsbranche eine Software bauen, die eingehende Schadensfälle automatisch an die richtigen Abteilungen leitet, musste er noch vor drei Jahren ein umfangreiches Projekt in Angriff nehmen:
- Es mussten genügend Daten für das Training und Testing eines ML-Modells beschafft oder erschaffen werden.
- Verschiedene Modell-Architekturen mussten trainiert und getestet werden.
- Das trainierte Modell musste in eine klassische Software integriert werden.
Oft wurde dieser Prozess in mehreren Iterationen bis zum Erreichen der gewünschten Qualität durchgeführt. Nur mit diesem beachtlichen Aufwand war es möglich, komplexe Probleme mithilfe von KI zu lösen. Mit dem Einzug von LLMs verändern sich die Möglichkeiten für solche Projekte. Anstatt selbst Daten zu sammeln und Modelle zu trainieren, reicht es heute oft, mithilfe von Prompt Engineering in einem sogenannten Zero-Shot Learning die richtigen Fragen zu stellen. Dazu zwei Beispiele aus Projekten:
Projekt 1 «Kundenkommunikation mit LLMs analysieren»
Beinahe jedes grössere Retail-Unternehmen sammelt durch die Kommunikation mit Kundinnen und Kunden wie Telefongesprächen, E-Mails oder Chats eine grosse Menge an Daten. Die Analyse dieser Daten kann einen grossen Mehrwert liefern: Sind die Kunden zufrieden mit den Produkten? Wenn nicht: Was sind die Gründe? Welche Bedürfnisse beschäftigen die Kundinnen und Kunden im Moment? In wie vielen Gesprächen wird wie häufig über Thema XY gesprochen?
Diese und weitere Fragen lassen sich heute mit verhältnismässig kleinem Aufwand beantworten. In einem ersten Schritt müssen dafür Telefongespräche transkribiert werden. Dafür existieren seit Jahren KI-Modelle, die mehr oder weniger zuverlässig Sprache in Text übersetzen. Gerade für Nischensprachen wie Schweizerdeutsch war die Qualität aber oft mangelhaft oder nur unter Einsatz von grossem Aufwand zu erreichen. Mit modernen KI-Modellen wie Whisper (Open Source, entwickelt von OpenAI) können heute auch Gespräche auf Schweizerdeutsch in sehr hoher Qualität in schriftdeutschen Text transkribiert werden. Selbst verhältnismässig schwierige Dialekte funktionieren auch ohne spezifisches Training problemlos. Ist die orale Kommunikation verschriftlicht, lässt sie sich sehr einfach mit GPT-4 analysieren. Dabei müssen, je nach Use Case, die richtigen Prompts entwickelt werden. Für eine einfache Zusammenfassung eines Gesprächs reicht dabei ein simpler Prompt wie «Bitte fasse das folgende Gespräch in drei Sätzen kurz und prägnant zusammen». Für andere Use Cases werden die Prompts etwas umfangreicher.
Special, Future of Work
Digitale Nachweise für die neue Arbeitswelt
Self-Sovereign Identity // In einem Use Case hat die CSS Versicherung zusammen mit ti&m ein Proof of Concept implementiert: Mittels einer digitalen Kundenkarte kann sich der Versicherte als Kunde bei einem Fitnesscenter ausweisen, die Buchungsbestätigung des Fitnesscenters wiederum bei der Versicherung gegen Bonuspunkte eintauschen und so seinen Besuch bestätigen lassen.
Konrad Durrer - 01.11.2022
Special
Vom Unsicherheitsfaktor zum Motivator
Dr. Jan Damrau - 01.03.2019
Special, Swiss-Software-AI
KMU-Kredite: unterschiedliche Wahrnehmung von Banken und KMU
Thomas Fischer - 05.09.2025