Schluss mit «Works on my Machine»: MLOps «Golden Path» Blueprint für regulierte Industrien
Wir starten ins Jahr 2026. Die Zeiten, in denen Data-Science-Teams ihre Modelle via USB-Stick oder als ZIP-File an die IT-Abteilung übergeben haben, sind endgültig vorbei. Die Tooling-Landschaft hat sich in den letzten Jahren massiv konsolidiert. Wir diskutieren heute nicht mehr darüber, ob wir Container brauchen, sondern wie wir die Supply Chain unserer KI-Modelle so absichern, dass sie nicht nur performant sind, sondern auch den steigenden Governance-Anforderungen standhalten.
Dennoch sehen wir in unseren Projekten bei ti&m oft ein Paradoxon: Während die Algorithmen immer komplexer werden (Transformers, Agentic Workflows), hinkt das Engineering hinterher. Da werden Notebooks in Produktion «gehackt» oder Pipelines gebaut, die so fragil sind, dass sich niemand traut, die requirements.txt anzufassen.
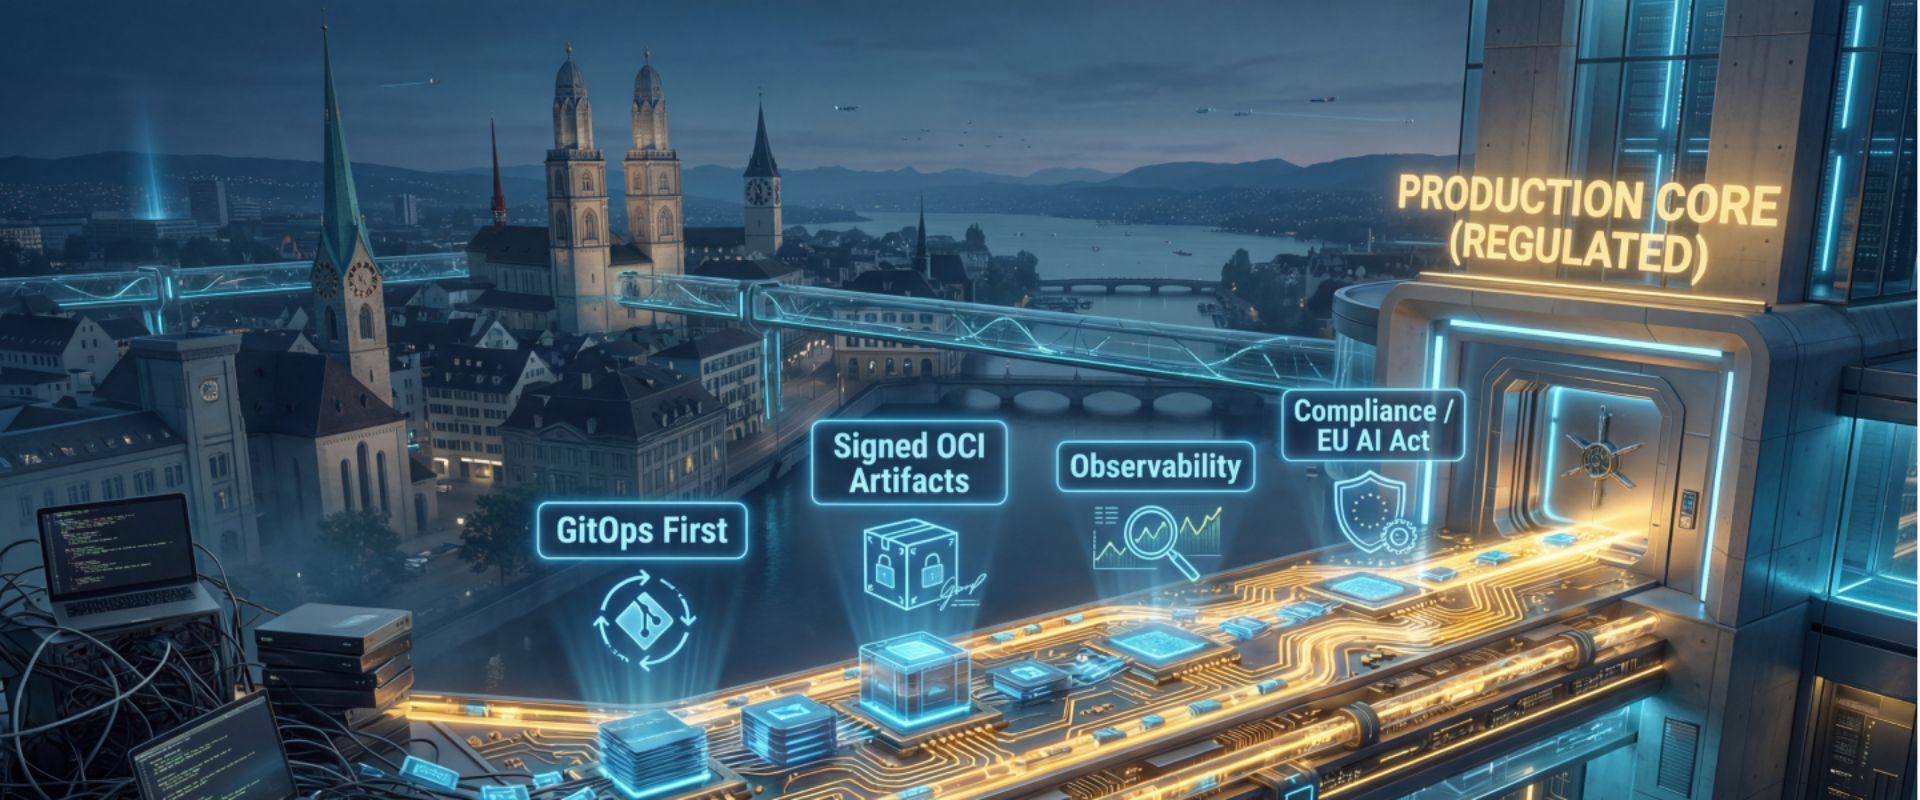
Für Unternehmen, die ML nicht als Spielwiese, sondern als geschäftskritischen Treiber sehen, gibt es nur eine Lösung: Platform Engineering. Wir müssen einen «Golden Path» bauen – eine standardisierte, hochautomatisierte Strasse in die Produktion.
In diesem Beitrag zeigen wir, wie ein solcher Blueprint aussieht, den wir für Kunden in regulierten Industrien (Banken, Versicherungen) heute architektieren. Wir schauen unter die Haube von GitOps, OCI-Artefakten, modernem Dependency Management mit uv und Observability.
Das Mindset: Compliance by Design und Schweizer Pragmatismus
Bevor wir Code anschauen, ein Wort zur Architektur. In einem regulierten Umfeld ist «Agilität» kein Freifahrtschein für Chaos.
Das Thema Regulierung – Stichwort EU AI Act – ist auch für Schweizer Unternehmen zentral. Zwar sind wir politisch unabhängig, aber wirtschaftlich stark verflochten. Sobald ein Schweizer Unternehmen KI-Services im EU-Raum anbietet, greift die Regulierung (Extraterritorialität). Zudem orientiert sich auch der Schweizer Gesetzgeber an internationalen Standards.
Für uns Technikerinnen und Techniker ist dabei gar nicht der juristische Text entscheidend, sondern die technische Implikation. Vor allem zwei Aspekte sind für MLOps-Plattformen relevant:
Technical Documentation & Record-Keeping (Art. 11 & 12): Wir müssen lückenlos beweisen können, wie ein Modell entstanden ist. Wer hat es trainiert? Auf welchen Daten? Mit welchen Parametern?
Accuracy, Robustness & Cybersecurity (Art. 15): Ein Modell darf nicht manipulierbar sein und muss gegen Angriffe geschützt werden.
Manuelle Schritte sind hier der Feind. Unser Ziel bei ti&m ist es daher, eine Plattform zu bauen, bei der Compliance das automatische Resultat ist, nicht ein Formular, das man am Ende ausfüllt.
Unsere Architekturprinzipien für 2026:
1. GitOps First: Die Single Source of Truth ist immer Git. Das garantiert die lückenlose Historie (Audit Trail).
2. Immutable Artifacts: Ein Modell ist ein binäres Artefakt, das einmal gebaut und dann unverändert durch die Stages (Dev, Test, Prod) promoted wird.
3. Separation of Concerns: Data Scientists liefern den Inhalt (Code + Parameter), die Plattform liefert den Rahmen (Security, Skalierung, Monitoring).
Deep Dive 1: Reproduzierbarkeit beginnt lokal (Die uv-Revolution)
Blicken wir kurz zurück. Dependency Management in Python war lange ein Albtraum. pip, poetry, conda, pipenv – das Auflösen von Abhängigkeiten dauerte oft Minuten.
2025 hat sich uv als De-facto-Standard durchgesetzt, und 2026 ist es aus modernen Stacks nicht mehr wegzudenken. Warum ist das für MLOps entscheidend? Weil Governance mit Reproduzierbarkeit steht und fällt.
Wenn ein Data Scientist lokal ein Modell entwickelt, muss die Umgebung bit-genau der Trainingsumgebung in der Cloud entsprechen. Früher führte «Works on my Machine» zu stundenlanger Fehlersuche in der CI-Pipeline.
Mit uv können wir Environments in Millisekunden erstellen und synchronisieren.
Ein Blick in die Praxis:
Statt einer losen requirements.txt nutzen wir strikte Lockfiles (uv.lock), die plattformübergreifend funktionieren.
Special, AI
«Digitale Ethik: In manchen Kontexten sollten wir keine autonomen Systeme einsetzen»
Digitale Ethik // Oliver Bendel forscht und publiziert seit Jahren über Informations-, Roboter- und Maschinenethik und wurde als Sachverständiger mehrfach in den Deutschen Bundestag und ins Europäische Parlament eingeladen. Wir haben mit ihm über die Chancen von KI, die Moral in der Maschine und Schuld und Verantwortung von autonomen Systemen gesprochen.
Oliver Bendel - 19.01.2024
Technology, Business
Warum es sich lohnt, einen Blick auf Podman zu werfen
Wenn es um Container-Management geht, ist Docker oft die erste Wahl. Allerdings kann auch Podman eine Alternative sein. In diesem Blogbeitrag werfen wir einen genaueren Blick auf die Unterschiede zwischen den beiden Tools und die Aspekte, die Sie bei der Verwendung von Podman beachten müssen.
Marc Merzinger - 03.09.2020
Technology
Wie sich die Stadt Zürich digitalisiert
Andreas Németh - 29.12.2021